논문 리뷰 - [FAST'25] Rethinking the Request-to-IO Transformation Process of File Systems for Full Utilization of High-Bandwidth SSDs
오늘 읽은 논문은 FAST 2025년에 발표된 Rethinking the Request-to-IO Transformation Process of File Systems for Full Utilization of High-Bandwidth SSDs란 논문이다.
간단하게 정리하자면 정렬되지 않은 쓰기를 하려고 할 때 파일 시스템에서 RMW(Read-Modify-Write) 동작을 수행하게 되는데, 이게 추가적인 I/O를 유발하여서 성능이 큰 악영향을 주는 병목 현상이라고 한다..
그래서 저자들은 정렬되지 않은 쓰기 범위 중 정렬된 부분은 SSD-IO로 처리하고 정렬되지 않은 범위는 NVM(Non-Volatile Memory)-IO로 처리하여 성능을 향상 시키는 것이 가장 큰 아이디어다.
Motivation
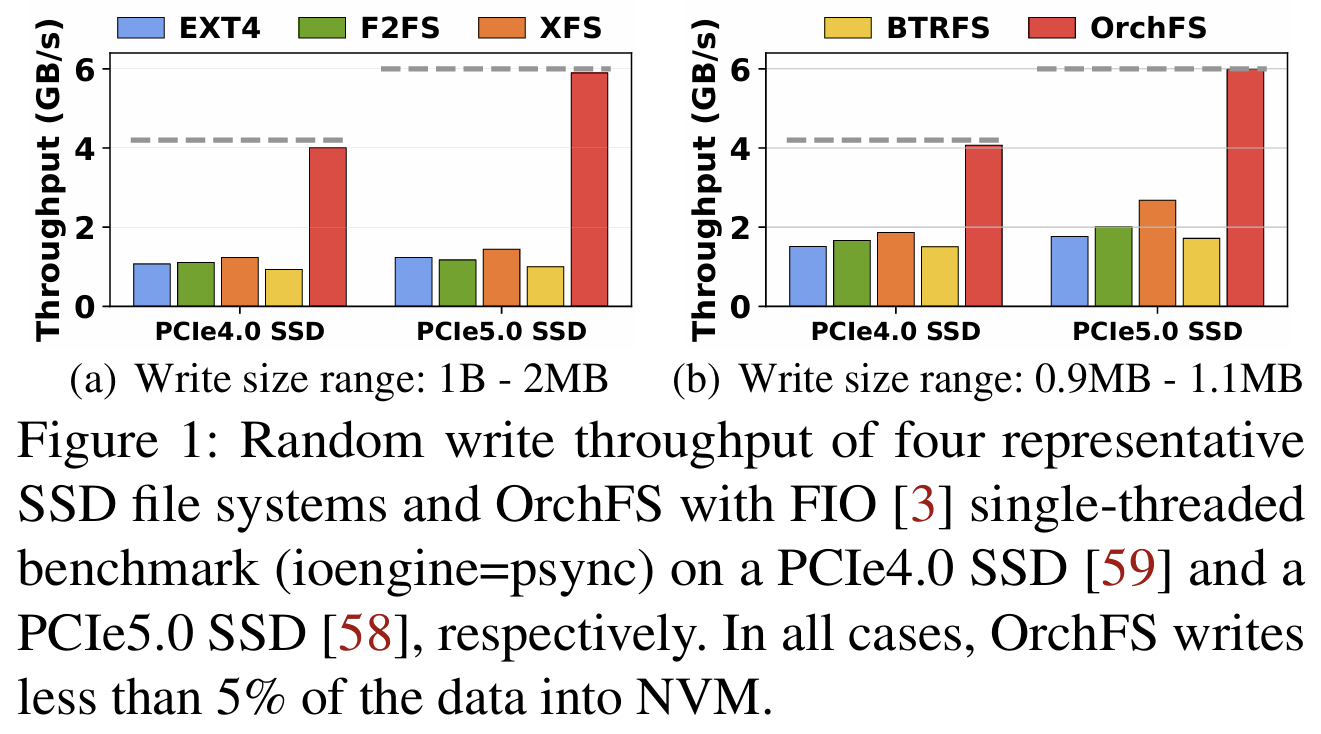 그림 1은 여러 파일 시스템에서 다양한 크기의 쓰기 성능을 측정한 결과로 저자들이 제안한 기법을 제외하면 SSD의 raw bandwidth에 1/3, 1/4 정도인 것을 볼 수 있다. 저자들은 그 원인을 RMW로 인한 I/O 증폭이 원인이라고 한다.
그럼 비정렬된 쓰기가 문제이니 정렬된 쓰기를 수행하면 성능이 급격하게 좋아질까? 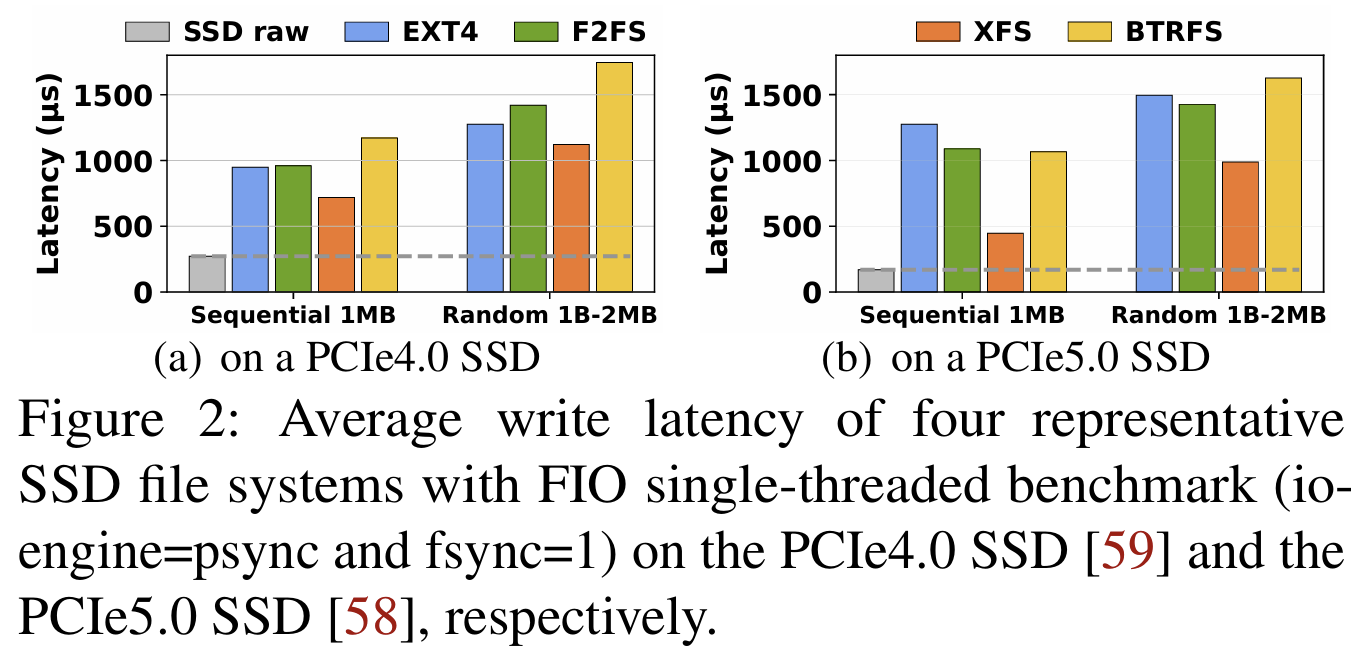 그림 2의 정렬된 1MB 순차 쓰기와 비정렬된 1B-2MB 랜덤 쓰기의 성능을 비교해보면 성능이 상승하긴 하지만 여전히 SSD raw bandwidth에 전혀 미치지 못한다.
이는 기본적으로 리눅스의 모든 쓰기, 읽기가 페이지 캐시(Page Cache)를 거치기 때문이다. 페이지 캐시는 파일 데이터를 메모리에 저장해 두어 동일 파일 데이터에 접근할 때 접근 횟수를 줄이기 위함이다. 페이지 캐시는 할당, 락(lock), 탐색, LRU 리스트 관리, 애플리케이션 버퍼와의 복사 동작이 필요하므로 추가적인 오버헤드를 가져온다.
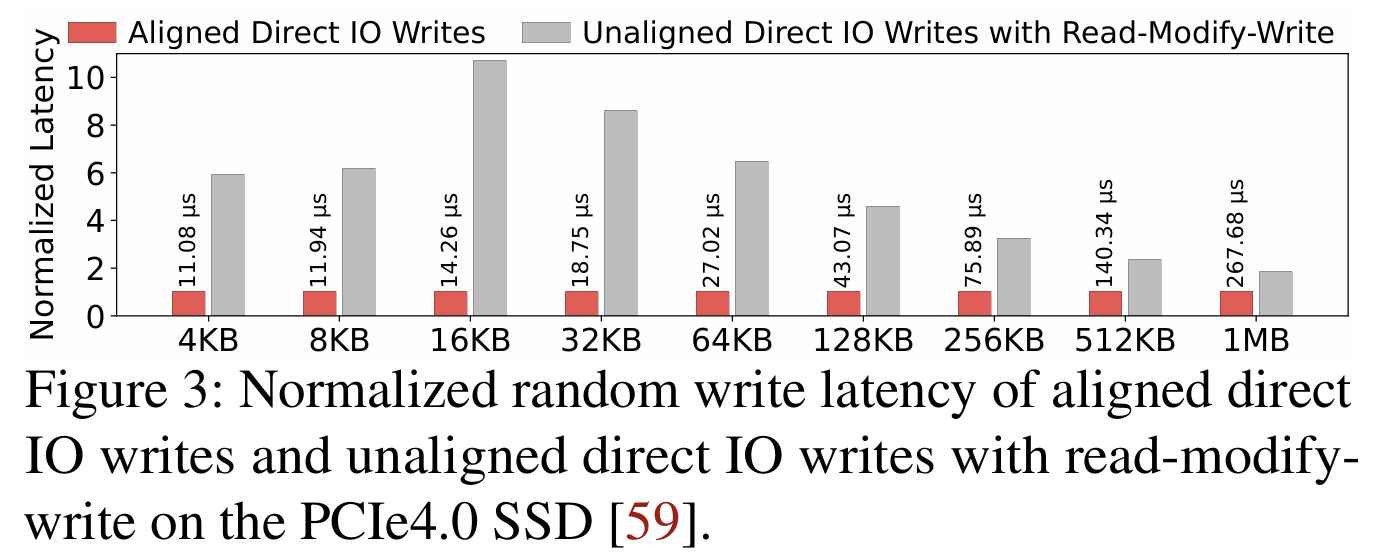 그림 3은 Direct I/O 경로를 사용하여 페이지 캐시 비용 없이, 정렬된 경우와 비정렬된 경우의 성능을 보여준다. 정렬된 Direct I/O는 비정렬된 I/O보다 1.85-10.71배의 높은 지연이 나타나며 RMW의 영향이 성능에 큰 영향을 미치는 것을 입증한다.
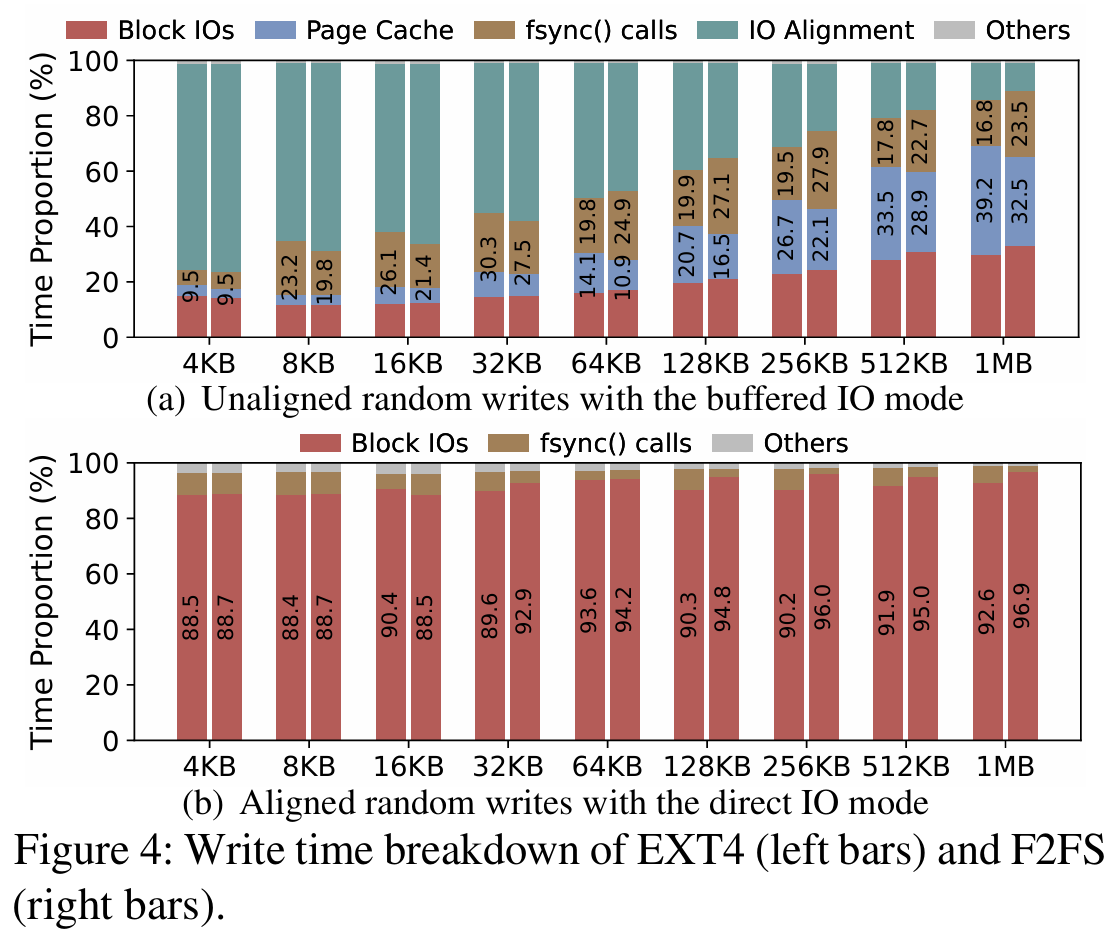 그림 4는 Buffered I/O 비정렬된 랜덤 쓰기와 Direct I/O 정렬된 랜덤 쓰기의 성능을 보여주며, 페이지 캐시 비용이 어느 정도의 영향을 미치는지 알 수 있다. Buffered I/O 경로에선 쓰기의 크기가 작을 땐 I/O alignment 비용이 대부분을 차지한다. 하지만 크기가 커질 수록 페이지 캐시 비용은 비정렬 쓰기에선 9.5%-56.0%, 정렬 쓰기에선 15.9%-65.8%를 차지하며 fsync() 비용은 1.9%-8.5%를 차지한다.
반면에 Direct I/O는 페이지 캐시를 거치지 않으니 대부분이 Block I/O 비용으로 효율적인 것을 알 수 있다. 평균 지연 시간도 Buffered I/O에 비해 Direct I/O는 12.9%-34.6%에 그친다.
하지만, 가장 이상적인 상황(정렬, 큰 크기, Direct I/O)의 경우에도 SSD raw bandwidth의 89%만을 활용할 수 있었다고 한다. 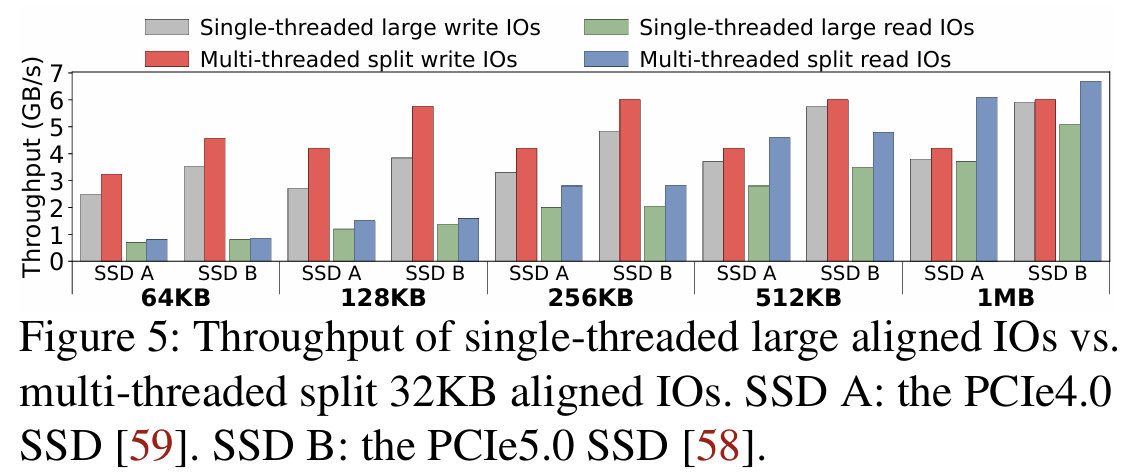 그림 5는 싱글 스레드와 멀티 스레드 간의 성능 차이를 보여주며, 싱글 스레드에선 각 I/O를 그대로 내려 보내고 멀티 스레드에선 각 I/O를 32KB 단위로 쪼개서 내려보낸다. 이때 싱글 스레드 IO 패턴 대비 1.02배–1.56배 및 1.06배–1.65배 높은 걸 볼 수 있다.
Proposal Design
이러한 실험을 통해 저자들은 아래의 세 가지 핵심 과제를 세우고 해결한다.
- 어떻게 다양한 오프셋과 크기의 쓰기를 효율적으로 분할하고, 비정렬된 범위의 쓰기를 처리할 수 있는가?
- 페이지 캐시를 사용하지 않고도 영속성(persistent)를 지킬 수 있는가?
- 어떻게 단일 I/O을 멀티 스레드로 처리할 수 있는가?
저자들은 위의 1-2번 과제를 해결하기 위해 NVM을 도입하여 SSD-NVM 이종(Heterogenous) 시스템을 설계한다. NVM은 바이트 단위 접근이 가능하고 영속성을 제공하기 때문에 현재 상황에 가장 적합한 하드웨어로써 정렬된 범위는 SSD, 비정렬된 범위는 NVM이 처리하는 형태로 파일 시스템을 구축한다.
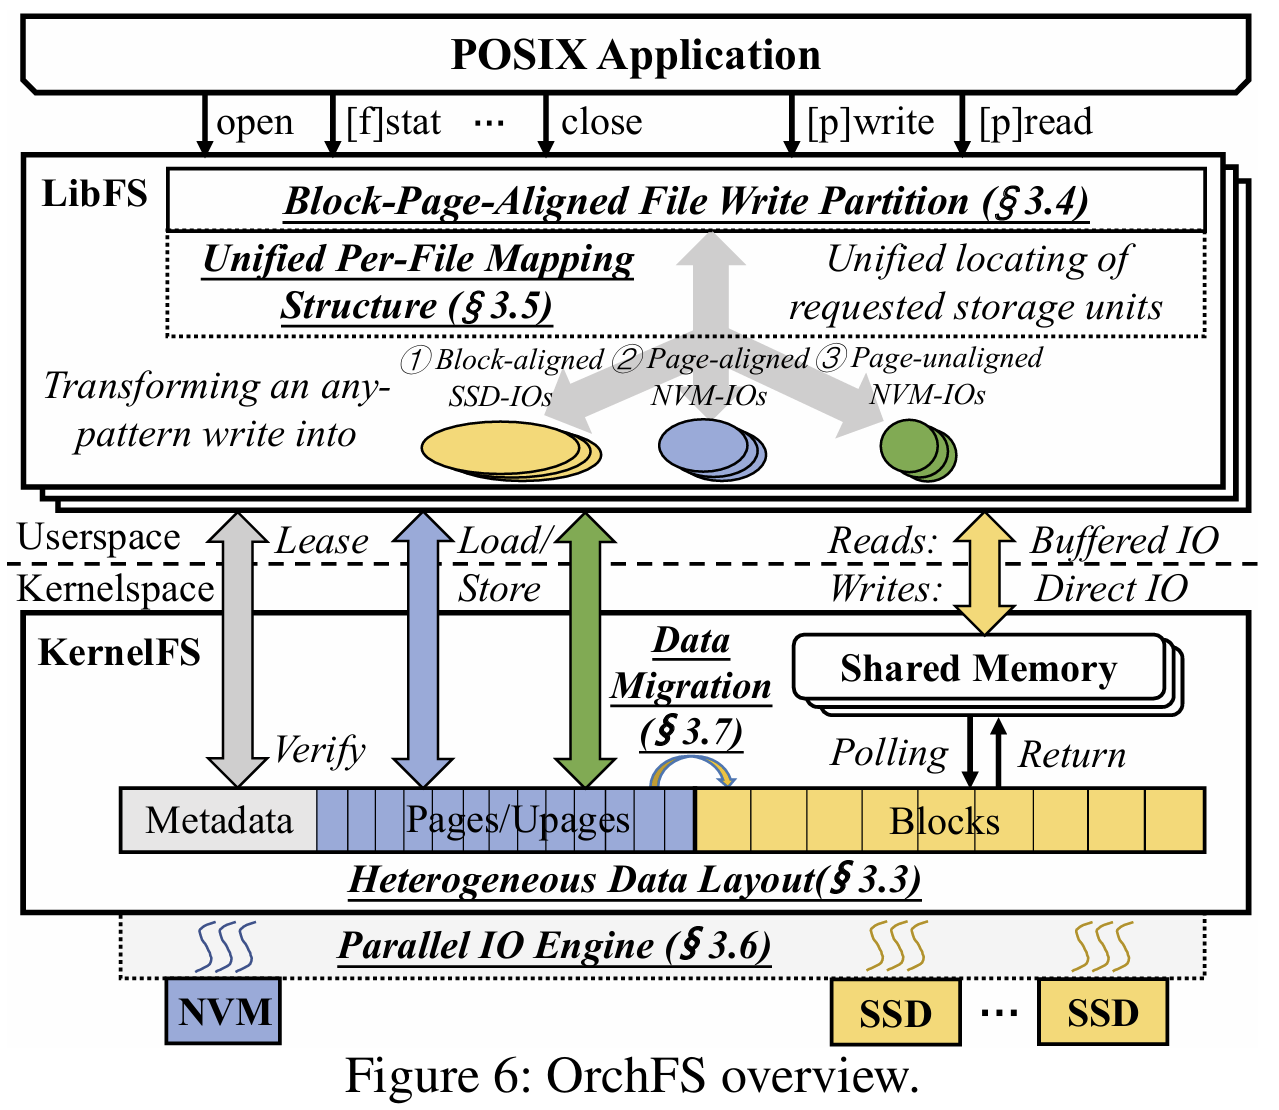 그림 6은 저자들이 제안하는 OrchFS의 구조도를 보여주며 크게 네 가지 주요 기술로 이루어진다.
- Heterogenous Data Layout
- Block-Page-Aligned File Write Partition
- Unified Per-File Mapping Structure
- Parallel I/O Engine
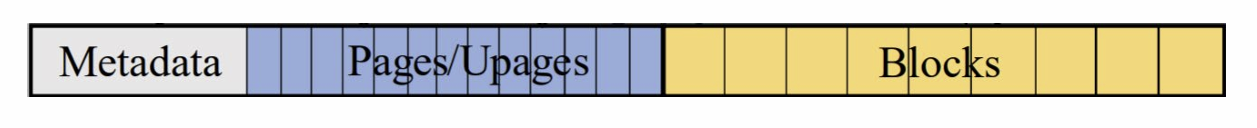 이종 데이터 레이아웃은 그림과 같이 생겼고 Metadata나 Page/Upage는 모두 NVM에 저장되며, 나머지 Block은 SSD에 저장된다. Block은 32KB로 정렬(시작 오프셋, 크기가 32KB의 배수)된 쓰기 범위이며, 정렬되지 않은 범위는 Page/Upage로 Page는 시작 오프셋은 페이지에 맞지만 크기가 32KB의 배수가 아닌 경우, Upage(Un-aligned page)는 시작 오프셋조차 페이지의 배수가 아닌 범위를 의미한다.
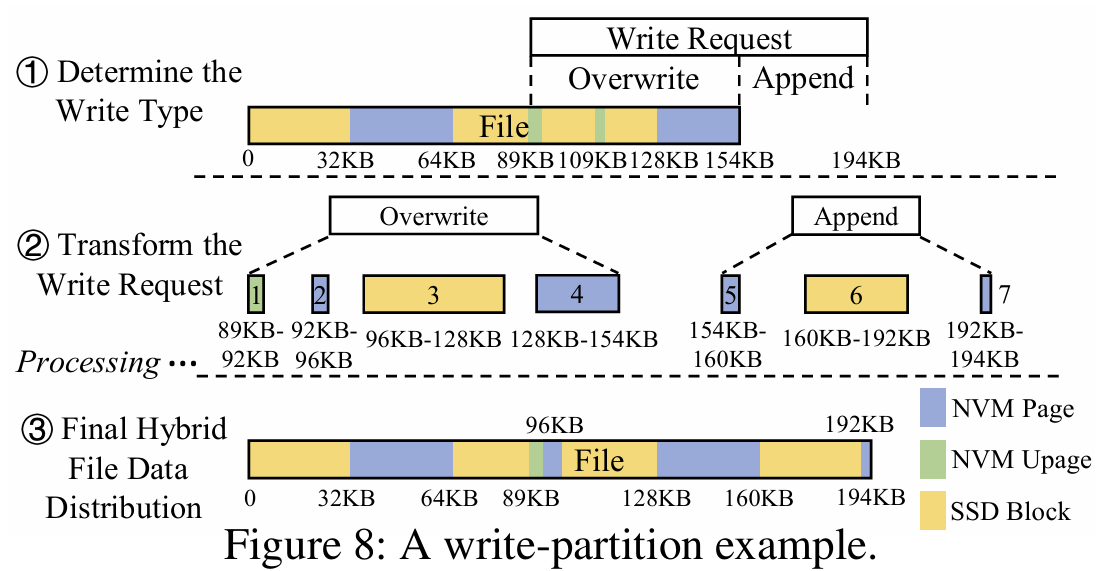 그림 8은 이종 데이터 레이아웃에 맞게 쓰기 범위를 자르는 과정을 나타낸다. 과정은 Overwrite과 Append로 나뉘며, 각 범위의 오프셋과 크기에 맞게 잘라지고 최대한 Fragmentation이 발생하지 않도록 한다. Overwrite 시 기존에 Page/Upage인 범위에 SSD-Block을 쓰려는 경우 NVM에서 해당 영역의 페이지들을 모두 회수하여 NVM이 넘치지 않도록 한다.
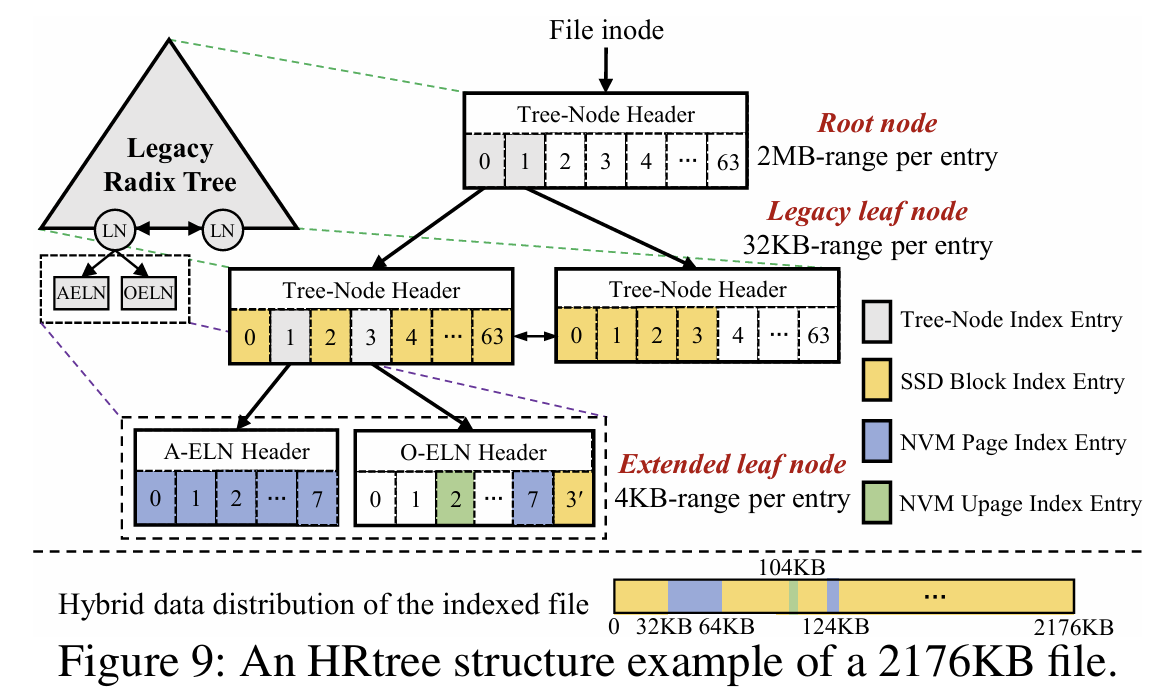 그림 9는 나뉘어져 저장된 파일들을 추적, 관리할 수 있는 자료구조로 기존의 라딕스(radix) 트리에서 확장 리프 노드(ELN, Extended Leaf Node)가 추가된 버전이다. 기존의 레거시 리프 노드(Legacy Leaf Node)에는 SSD-Block의 인덱스가 저장되어 있고, Append나 Overwrite 시 NVM에 저장되는 범위는 확장 리프 노드에 A-ELN(Append-ELN) 또는 O-ELN(Overwrite-ELN)으로 저장된다.
A-ELN은 64B의 헤더와 8B의 인덱스 엔트리로 구성되어 있으며 NVM Page로 채워진다. O-ELN은 64B의 헤더와 덮어 쓰여진 SSD-Block을 위한 8B의 인덱스 트리, 8*64B의 인덱스 엔트리로 채워진다.
- 64B 인덱스 엔트리는 56B의 Upage 헤더와 8B의 인덱스 엔트리로 채워지며, 일반 Page의 경우 헤더는 무효화된다.
- Upage의 경우는 페이지 보다 더 작은 경우가 많아 Upage 만을 위한 별도의 헤더를 추가로 유지
마지막으로 Parallel I/O Engine은 SSD-Block, NVM Page/Upage로 내려온 하나의 스트림(Stream)을 크기에 맞게 분할하여 병렬로 저장하거나 읽을 수 있도록 구현하여, I/O Concurrency 문제까지 해결했다고 한다.
- 하드웨어의 속도 차이로 인하여 SSD-Block을 위한 스레드는 32개, NVM Page/Upage를 위한 스레드는 4개로 설정
- 각 스레드는 배타적(Exclusive)으로 할당된 주소 범위 내에서 I/O를 순차적으로 수행하여 일관성을 유지
Evaluation
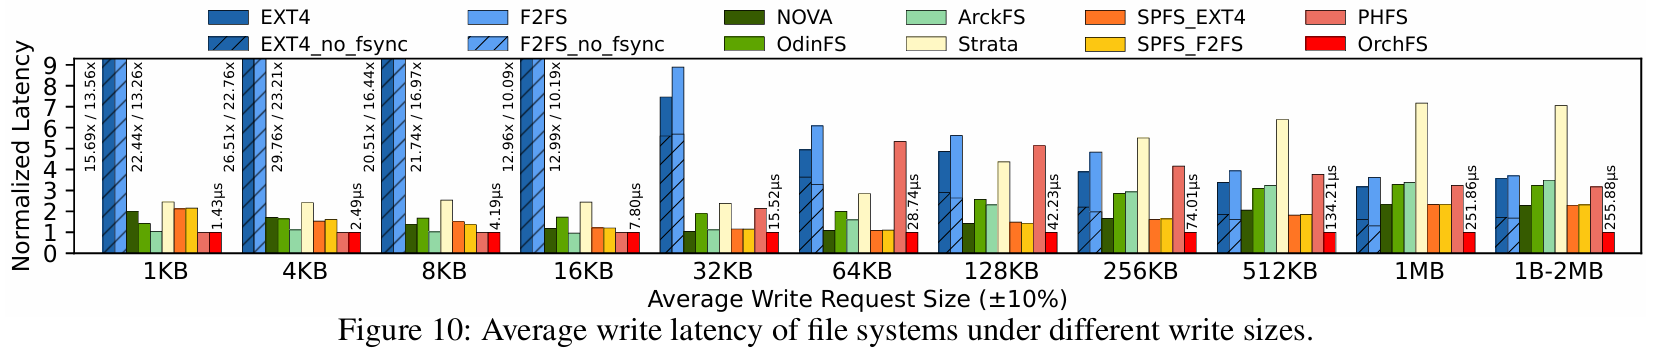 그림 10은 SSD FS, NVM FS, SSD-NVM FS들의 성능을 비교한 것으로 쓰기 크기가 32KB 이하인 경우에는 SSD FS에서 압도적으로 높은 지연 시간을 보여주고, NVM 또는 SSD-NVM FS에선 비슷한 성능을 보여준다. 하지만 64KB 이상 부턴 점차 차이가 줄어들며 NVM, SSD-NVM FS의 지연 시간을 증가함에 반해 저자들의 제안 기법인 OrchFS는 여전히 낮은 지연 시간을 보여준다.
이는 다른 NVM 활용 파일 시스템에선 쓰기 시 발생하는 근본적인 원인을 해결한 것이 아니라, SSD를 사용해야 하는 크기가 되면 성능이 저하되는 것으로 설명한다.
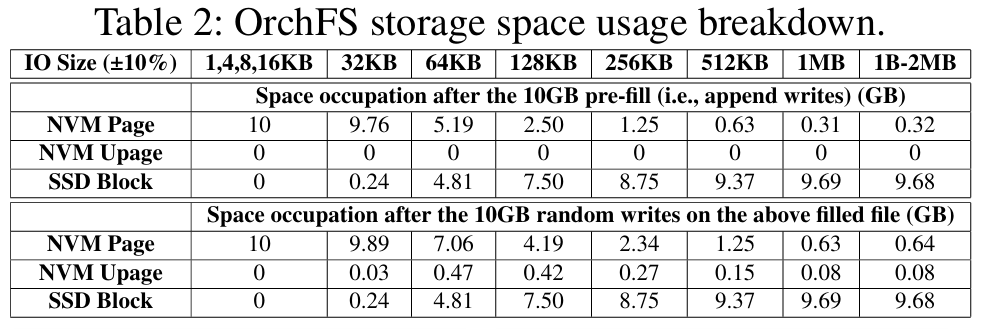 표 2는 OrchFS에서 10GB를 쓸 때 NVM, SSD가 차지하는 용량을 보여준다. 다른 파일 시스템을 비교할 순 없어도 각 쓰기 범위에 따라 점차 SSD에 대부분의 데이터가 저장되는 것을 보여줌으로써 SSD로의 쓰기 효율성을 개선했음을 나타낸다.
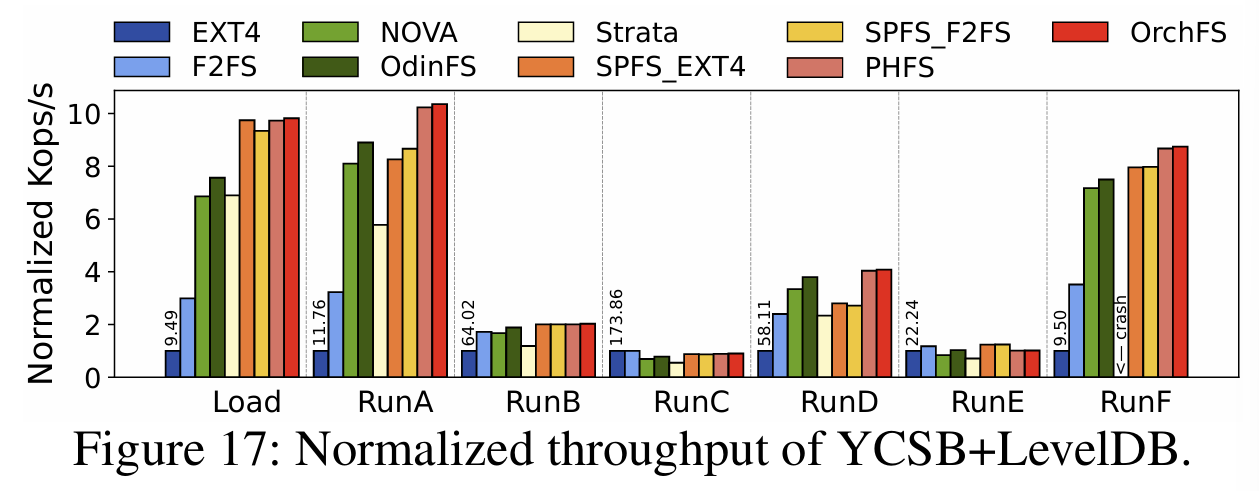 그림 17은 YCSB+Level DB에서의 실험 결과를 보여준다. 이때는 다른 NVM, SSD-NVM FS와 큰 차이가 없는데, 이는 YCSB에서 다루는 데이터의 크기가 1KB로 대부분의 데이터를 NVM에서 처리하기 때문이라고 한다.
Conclusion
비정렬된 쓰기에서 발생하는 RMW를 제거하기 위해 새로운 하드웨어를 혼합하여 사용하는 것이 인상적이지만, 결국 NVM이 없어 비정렬된 범위를 처리할 수 없다면 쓸모가 없어지는 게 아닌가 싶다. 물론 연구이니 큰 상관은 없겠지만서도 NVM 없이도 동일한 문제를 해결할 수 있는 방법이 있다면 확실히 좋은 방향인 것 같다.